


React SEO: React Tabanlı Siteler İçin En İyi Optimizasyon Yöntemleri
React ile SEO çalışmalarının nasıl uyumlu olabileceği, Google’ın bu tür siteleri nasıl taradığı ile ilgili örnekleri bu makalemizde bulabilirsiniz. Altyapı değiştirirken ya da yeni bir site kurarken yazıda yer alan önerileri uygulayabilirsiniz.
React'te SEO sorunlarının neredeyse tek bir sorunu oluyor. İçerikleri tarayıcıya mı yoksa sunucuya mı render ettirmeliyiz? Bu yazıda bu sorularınızı detaylı bir şekilde cevaplandıracağım.
SEO’ya giriş yapmadan önce Google’ın Javascript’i nasıl taradığı ve indeksine hangi aşamaları kullanarak sayfaları dahil ettiğini aşağıdaki görselden anlayabiliriz. Bir sayfa indekse girmeden önce birçok aşamadan geçmekte ve ardından indekse dahil edilmektedir. Google’ın günlük taradığı sayfa sayısını düşününce, Googlebot’a sorunsuz bir deneyim yaşatıldığı takdirde, içeriği tam olarak tarayıp indeksine dahil ederek sıralamada sayfaya yer verebilir.
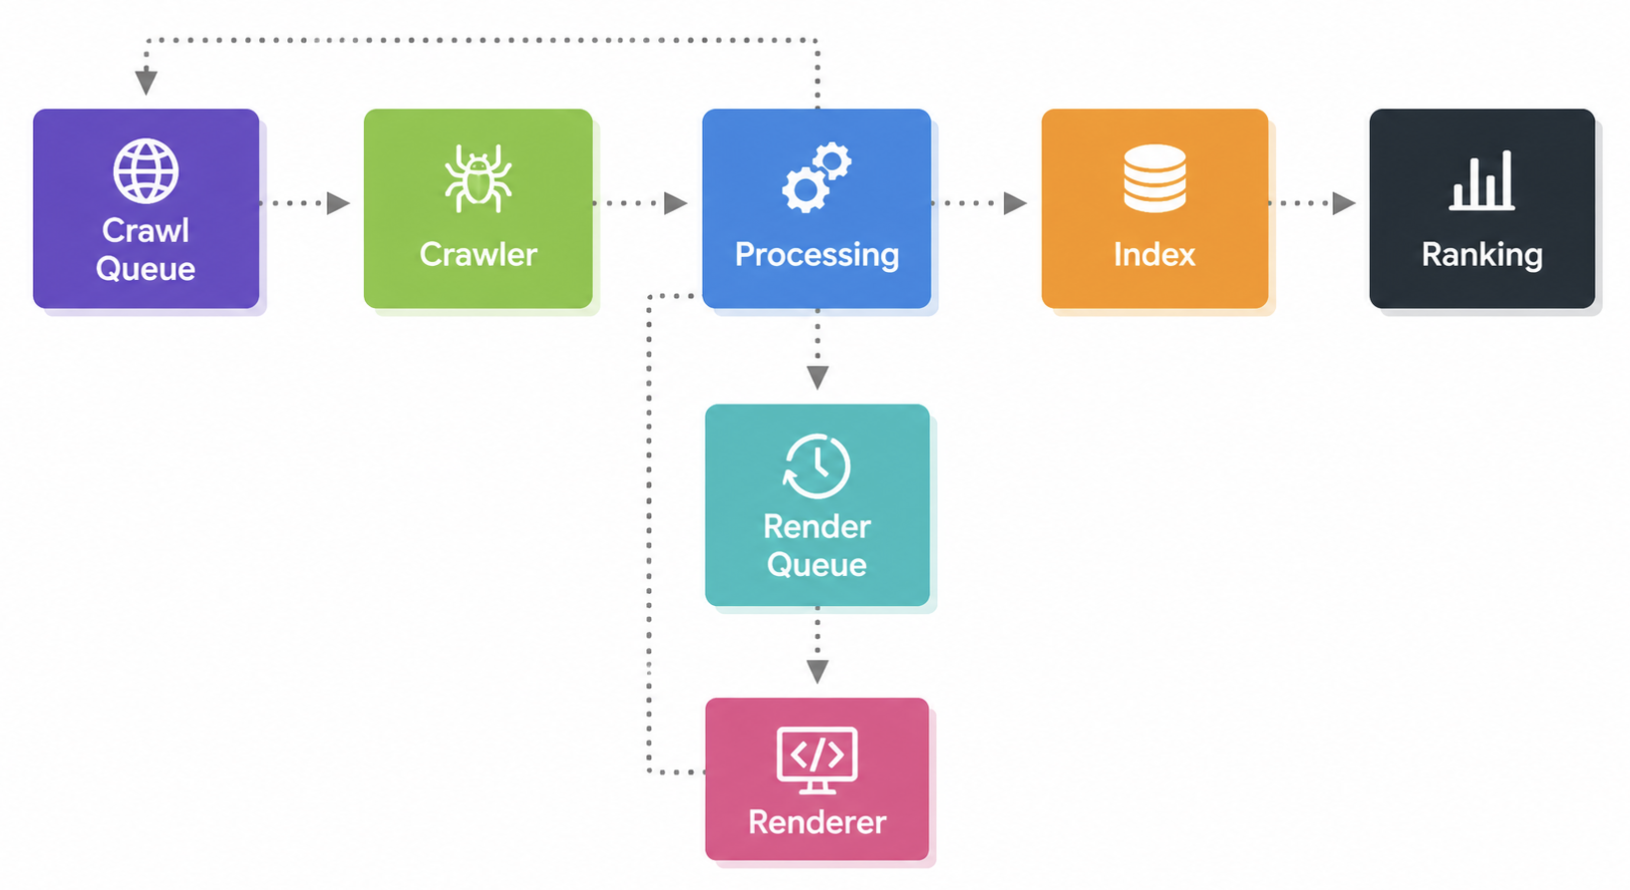
- Render, taramadan ayrı bir şekilde çalışır. JavaScript ile gelen içerikler dizine daha geç girer.
- Render işlemi her zaman garanti bir işlem değildir. Render işleminin zaman aşımı, JS hataları, robots.txt ile engellenen JS veya API kaynakları yüzünden Googlebot sayfayı boş görebilir.
- E-ticaret gibi stok ve fiyat değişimlerinin sürekli olduğu ya da haber girişlerinin çok sık yaşandığı yayıncı sitelerinde bu gecikmeler düzgün yönetilemezse ticari kayba neden olur.
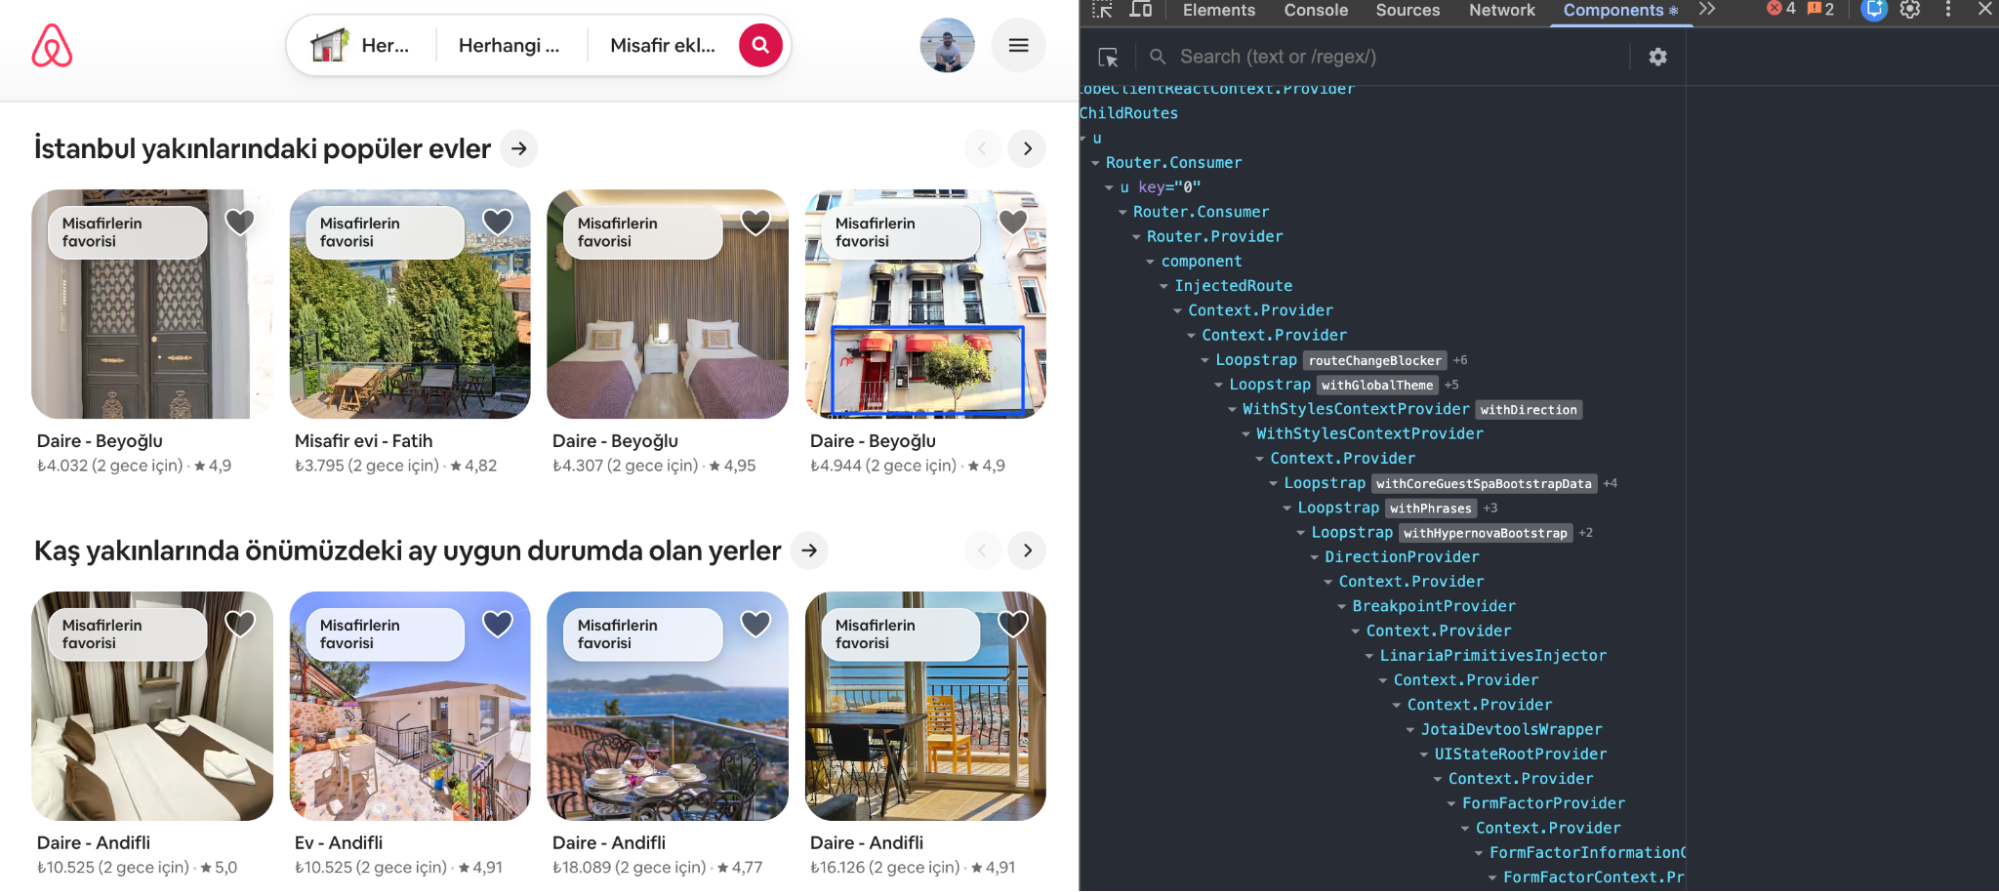
Kısa bir bilgi verdikten sonra React optimizasyon işlemlerine başlayabiliriz. React Framework’ü kullanılarak yazılmış bir site örneğini aşağıda görebilirsiniz;
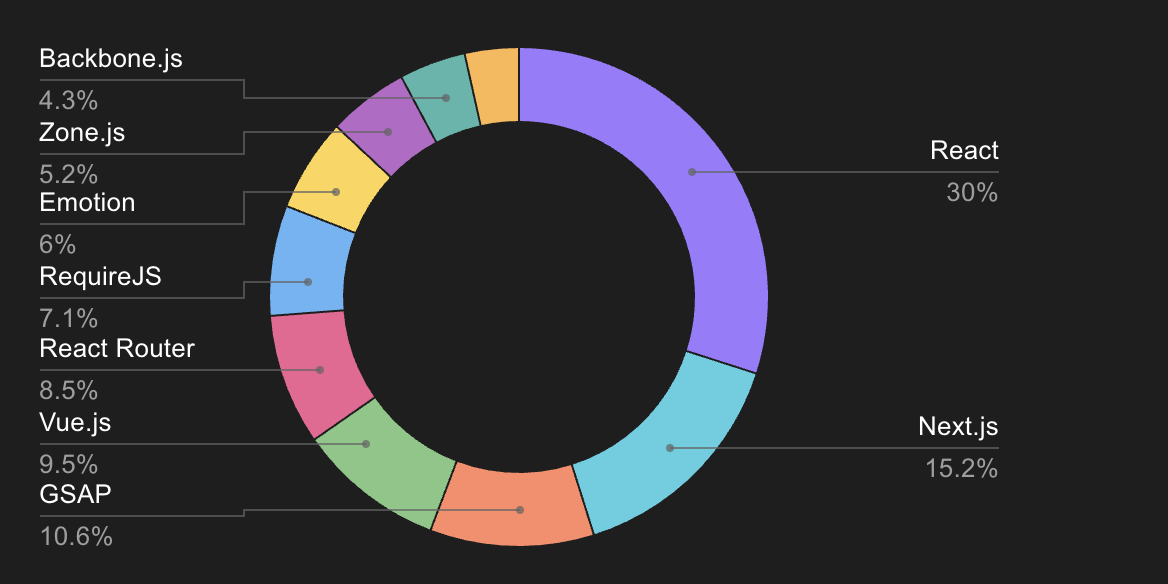
Pazar liderlerinin hangi JS frameworkleri kullandığını ise aşağıdaki görselde bulabilirsiniz. React 1. sırada yer alıyor. Google, diğer Javascript framework’lerini render edebildiği gibi React’ı da render edebilmektedir.
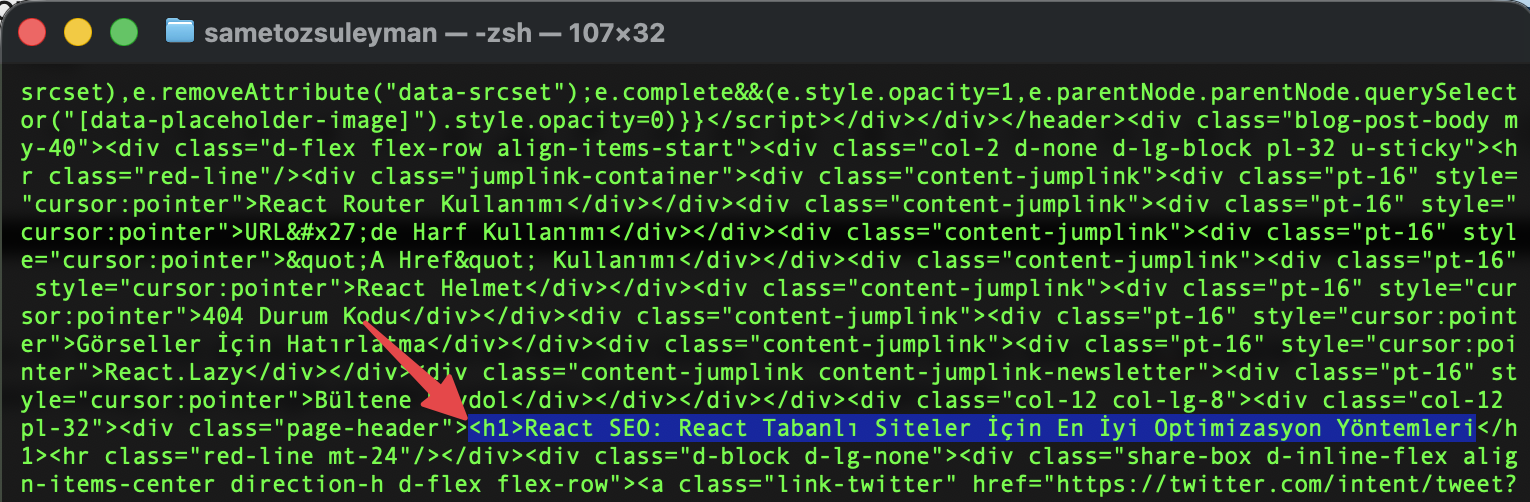
Şu an bu yazıyı okuduğunuz sayfa da React ile kurulu. Sunucudan gelen raw HTML'de içerik hazır olduğu için Google render kuyruğunu beklemek zorunda kalmıyor:
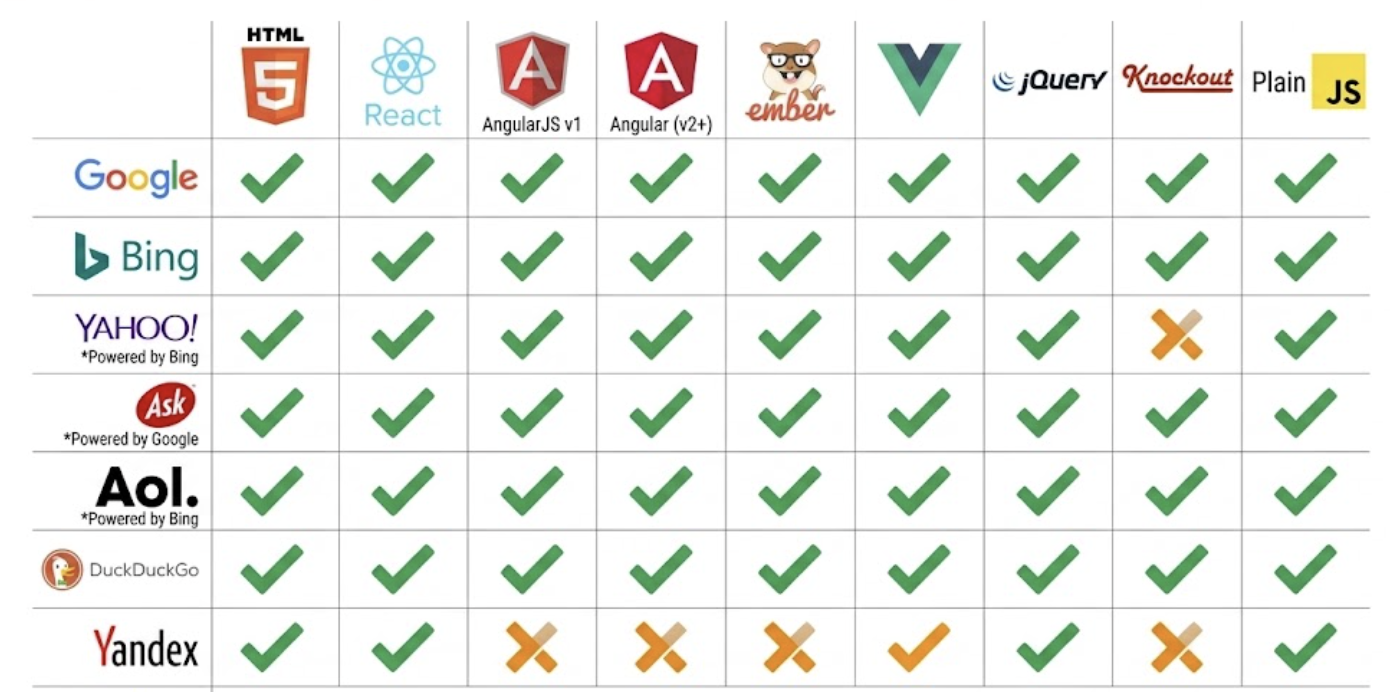
JavaScript Çalıştıran ve Çalıştıramayan Arama Motorları
Google ve Bing gibi arama motorları eskiye göre çok daha iyi düzeyde render edebiliyor:
Googlebot zaten render edebiliyor; lakin GEO çalışmalarında çok sık analizlerini yaptığımız: GPTBot, ClaudeBot ve PerplexityBot gibi AI tarayıcılarının CSR & SSR desteklerini aşağıdaki tablodan inceleyebilirsiniz:
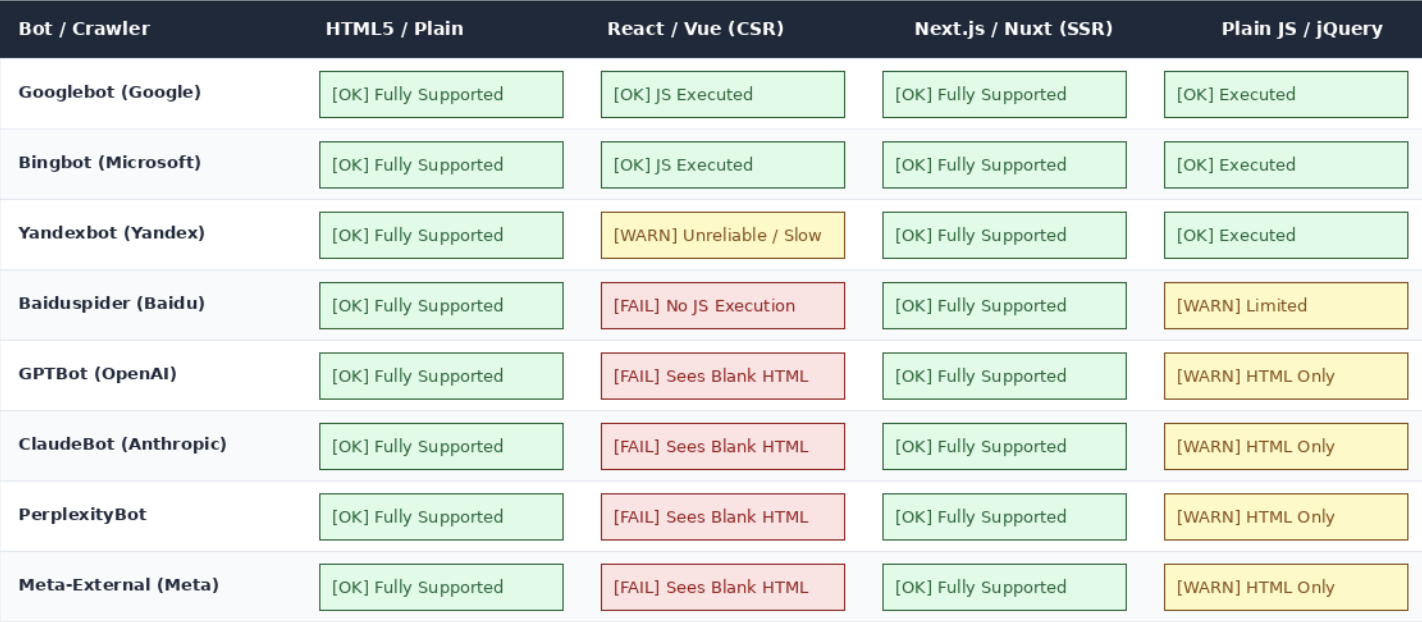
CSR edilen bir sayfa Google'da sıralanabilir; fakat LLM yanıtlarında hiç görünmeyebilir. Bu detaylara göre sayfalarınızı kontrol edebilirsiniz.
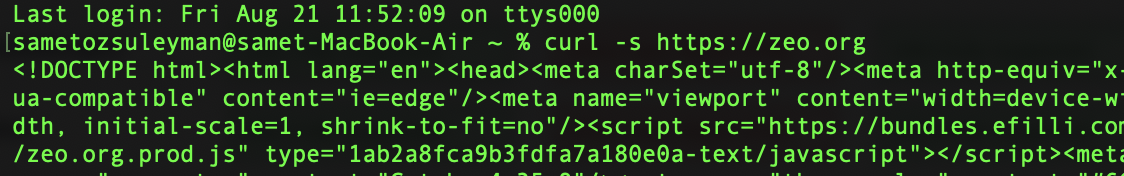
Kontrol yöntemimiz ise oldukça basit:
curl -s https://site.com yazıyoruz terminal çıktısında içerik yoksa botlar için de içerik yoktur:
Render Stratejisi
React'te SEO sorunlarının büyük kısmı aslında yanlış kütüphane seçiminden değil, yanlış render kararından ortaya çıkar. Stratejiyi kurgularken aşağıdaki yaklaşımları baz alarak karar vermenizi öneririm. Bu terimleri bilerek detaylı bir şekilde anlatmak istiyorum ki en başta sorun yaşamadan tüm sistemi sorunsuz kurabilelim:
CSR (Client-Side Rendering): Sunucu neredeyse boş bir HTML gönderir, içeriği tarayıcıdaki JS oluşturur. Kullanıcıya göre her şey normal görünür; lakin HTML tamamen boştur.
SSR (Server-Side Rendering): HTML her istekte sunucuda üretilir ve sayfa içleri dolu olarak iletilir. Fiyat, beden ya da stok durumları gibi çok sık değişen sayfa tipleri için uygundur.
SSG (Static Site Generation): HTML build sırasında bir kez üretilir, sonra tüm botlara aynı dosya sunulur. En hızlı ve en az hata payı olan yöntemlerden birisidir.
|
Page Type |
Önerilen |
Neden Öneriyoruz? |
|
Blog ve kurumsal sayfalar |
SSG |
Bu sayfalardaki içerikler nadiren değişiyor. |
|
PDP, PLP ya da ilan/araç listelem sayfaları |
SSR |
Fiyatlar ile stok bilgileri sık değişir, ama bu LP’lerin dizine girmesi gerekmektedir. |
|
Müşteri paneli, hesabım, sepet, ödeme sayfaları |
CSR |
SEO gereksinimleri yok dizine girmesi gerekmiyor. |
Yani özetle Google ve özellikle AI sonuçlarında yer alması gereken sayfaları CSR ile sunmamanızı öneririm. Gördüğünüz gibi tüm siteyi SSR ile yapmamız gerekmiyor; örneğin ödeme sayfalarında CSR kullanabilirsiniz. Blog sayfalarında da bilerek SSG ekledim; çünkü blogların güncellemesinin 10 dakika geç yansıması sorun olmayacaktır; ama e-ticaret sitelerinde fiyatın 10 dakika gecikmesi sorun oluşturacaktır. Sanırım farkı bu şekilde sizlere özetleyebildim.
React Router Kullanımı
Bilindiği üzere React bir SPA (tek sayfalık site) olmayı benimsemiştir; ancak eğer belirli kuralları ve SEO elementlerini düzgün bir şekilde sayfalarımızda belirtirsek SPA modelini gelişmiş halde kullanabiliriz.
Sayfaların # (hashtag) şeklinde olmadan ayrı bir URL olarak açılması bizim için çok önemlidir. Google, hash ile ilgili URL’leri okuyamadığını belirttiği için bu tür URL’ler eğer React ile oluşursa Google bunları indexlemeyebilir. Bundan dolayı her URL ayrı sayfalarda açılacak şekilde oluşturulmalıdır.
Önerilmeyen örnek hash içeren URL: www.siteadi.com/#zeo-react
Doğru aksiyon, yönlendirmenin History API üzerinden yapılması. React Router bunu varsayılan olarak BrowserRouter ile sağlıyor; HashRouter kullanıyorsanız URL'leriniz hash içerir ve bu sayfalar dizine girmez.
URL’lerde React Router kullanmalıyız. Örnek görünümü aşağıdaki bulabilirsiniz;
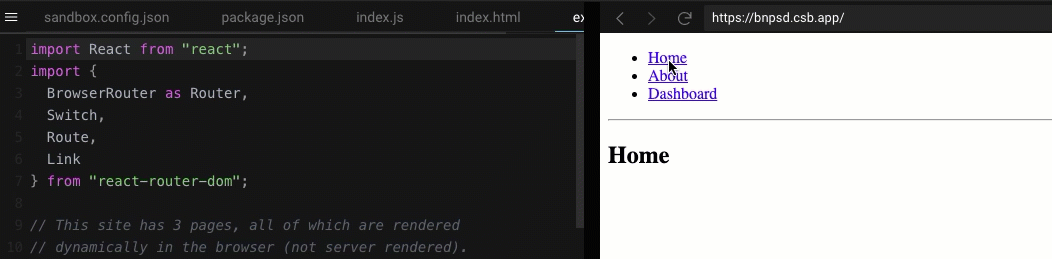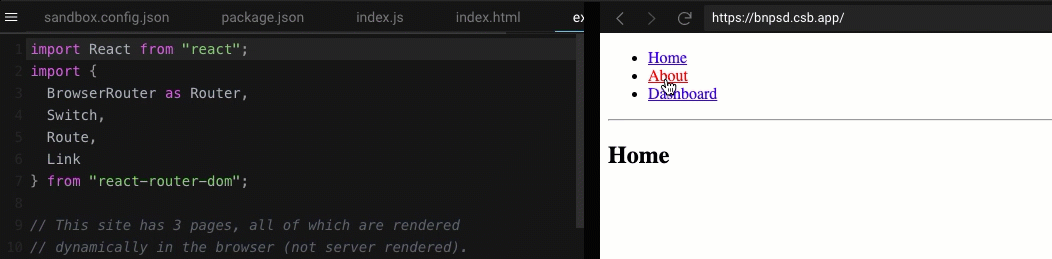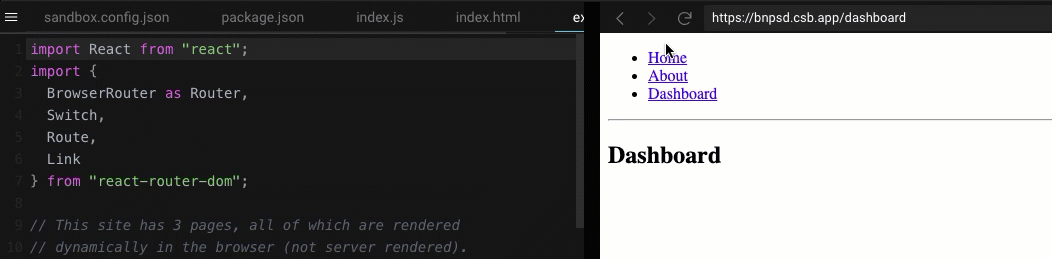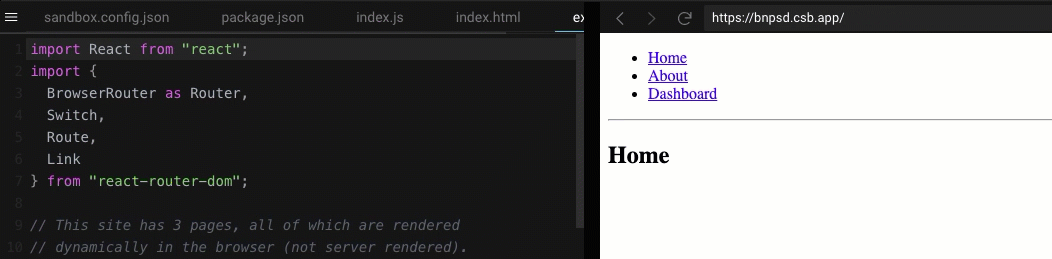
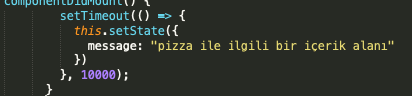
İçeriği oluştururken setTimeout ile belirli bir saniye sonrasında içeriği ekrana getirme gibi bir işlemin yapılmamasını öneririz. Googlebot bu tür durumlarda sayfada kalmayabilir ve içeriği okuyamadan siteden ayrılabilir; çünkü G-Bot durumsuz bir ziyaretçidir. Sayfayı açar, içeriği görür ve ayrılır. Cookie ve localStorage taşımaz veya bildirim izni isteyen API'lere yanıt vermez.
Bundan dolayı indexlenmesini istediğimiz içerik, hiçbir kullanıcı etkileşimi olmadan ilk render anında hazır olmalı. Örneğin "ziyaretçi aşağı inince içerik yükleniyor" dediğimiz durumlarda Google içeriği göz ardı edebilir:
PLP’ler ve blog & haber arşiv sayfalarındaki paginationlarda sonsuz kaydırma kullanıyorsanız şuradaki yazıdakileri uygulamanızı öneririm.
trailingSlash & middleware Kullanımı
URL’lerde küçük/büyük harf kullanımı Google’ın bu sayfaları ayrı bir sayfa olarak görmesine sebep olmaktadır. Bunu özellikle react projelerinde sıklıkla görüyoruz. Yönlendirmeler uygulama içinde yapıldığı için, router büyük ve küçük harf yazımlarını aynı bileşene eşleyip sayfayı sorunsuz açar; ama bu biz SEO danışmanları için ciddi bir sorun oluşturur.
Aksiyon olarak önerim: Küçük harf + sondaki slash olmayacak şekilde URL yapısını oluşturmanız. Next.js'te next.config.js içinde aşağıdaki kodu ekleyebilirsiniz. Bu sayede sondaki slash içeren istekleri yönlendirecektir:
module.exports = {
trailingSlash: false,
};
Büyük-küçük harf kuralı için de ayrı bir kural gerekmektedir. Next.js'te middleware ile:
import { NextResponse } from "next/server";
export function middleware(request) {
const { pathname } = request.nextUrl;
if (pathname !== pathname.toLowerCase()) {
const url = request.nextUrl.clone();
url.pathname = pathname.toLowerCase();
return NextResponse.redirect(url, 308);
}
}
Linklerde “A Href” Kullanımı
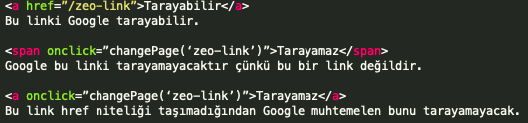
Linkler mutlaka “a href” ile verilmelidir; onclick ile verilen linkleri Googlebot okuyamamaktadır. Googlebot sayfaya geldiğinde diğer alakalı sayfaları bulması ve ziyaret etmesi için mutlaka linklerin a href ile belirtilmesi gerekmektedir.
Meta Verileri Yönetmek
SEO’nun temel yapı taşlarından olan meta verilerin mutlaka React alt yapısı kullanılsa bile kaynak kodda görünmesi gerekmektedir. Aynı description ve title yapılarının kullanılması CTR ve diğer metriklerde fayda sağlamayabilir;
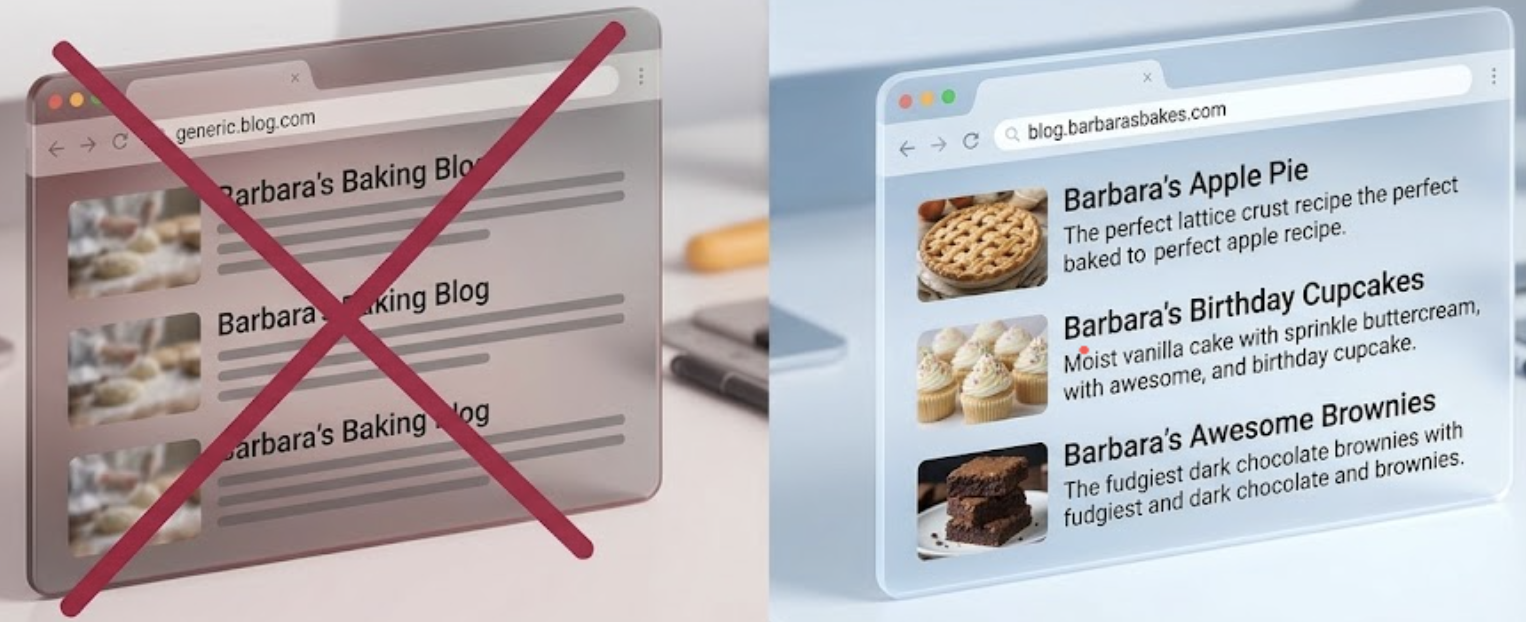 Görsel: Martin Splitt, React Developers
Uzun yıllar boyunca bu iş için react-helmet kullanıldı; fakat paket aktif olarak geliştirilmiyor. Next.js App Router kullanıyorsanız: Metadata API
export async function generateMetadata({ params }) {
const urun = await getUrun(params.slug);
return {
title: `${urun.ad} | Zeo Markası`,
description: urun.kisaAciklama,
alternates: { canonical: `https://zeo.org/urunler/${urun.slug}` },
openGraph: { images: [urun.gorsel] },
};
}
Next.js Pages Router kullanıyorsanız: next/head
import Head from "next/head";
export default function Urun({ urun }) {
return (
<Head>
<title>{urun.ad} | Zeo Markası</title>
<meta name="description" content={urun.kisaAciklama} />
<link rel="canonical" href={`https://zeo.org/urunler/${urun.slug}`} />
</Head>
);
}
Henüz bir framework kullanmıyorsanız ve React 19'a geçtiyseniz bu meta etiketleri herhangi bir yerde render edebiliyor ve React bunları otomatik olarak <head> içine taşıyor:
Meta verilerin yanı sıra structured data öğelerinin de kaynak kodda yer alması gerekmektedir. (Product, organization schema vb.)
function UrunSayfasi({ urun }) {
return (
<>
<title>{urun.ad} | Zeo Markası</title>
<meta name="description" content={urun.kisaAciklama} />
<link rel="canonical" href={`https://zeo.org/urunler/${urun.slug}`} />
<h1>{urun.ad}</h1>
</>
);
}
Kesinlikle test edin dediğim durumlar:
-
Canonical ve varsa hreflang mutlaka raw HTML'de yer almalı.
-
HTML'de noindex varken render sonrası kaldırılıyorsa Google ilk gördüğü değeri esas alacağı için bu sayfalar dizinden kaldırılır.
-
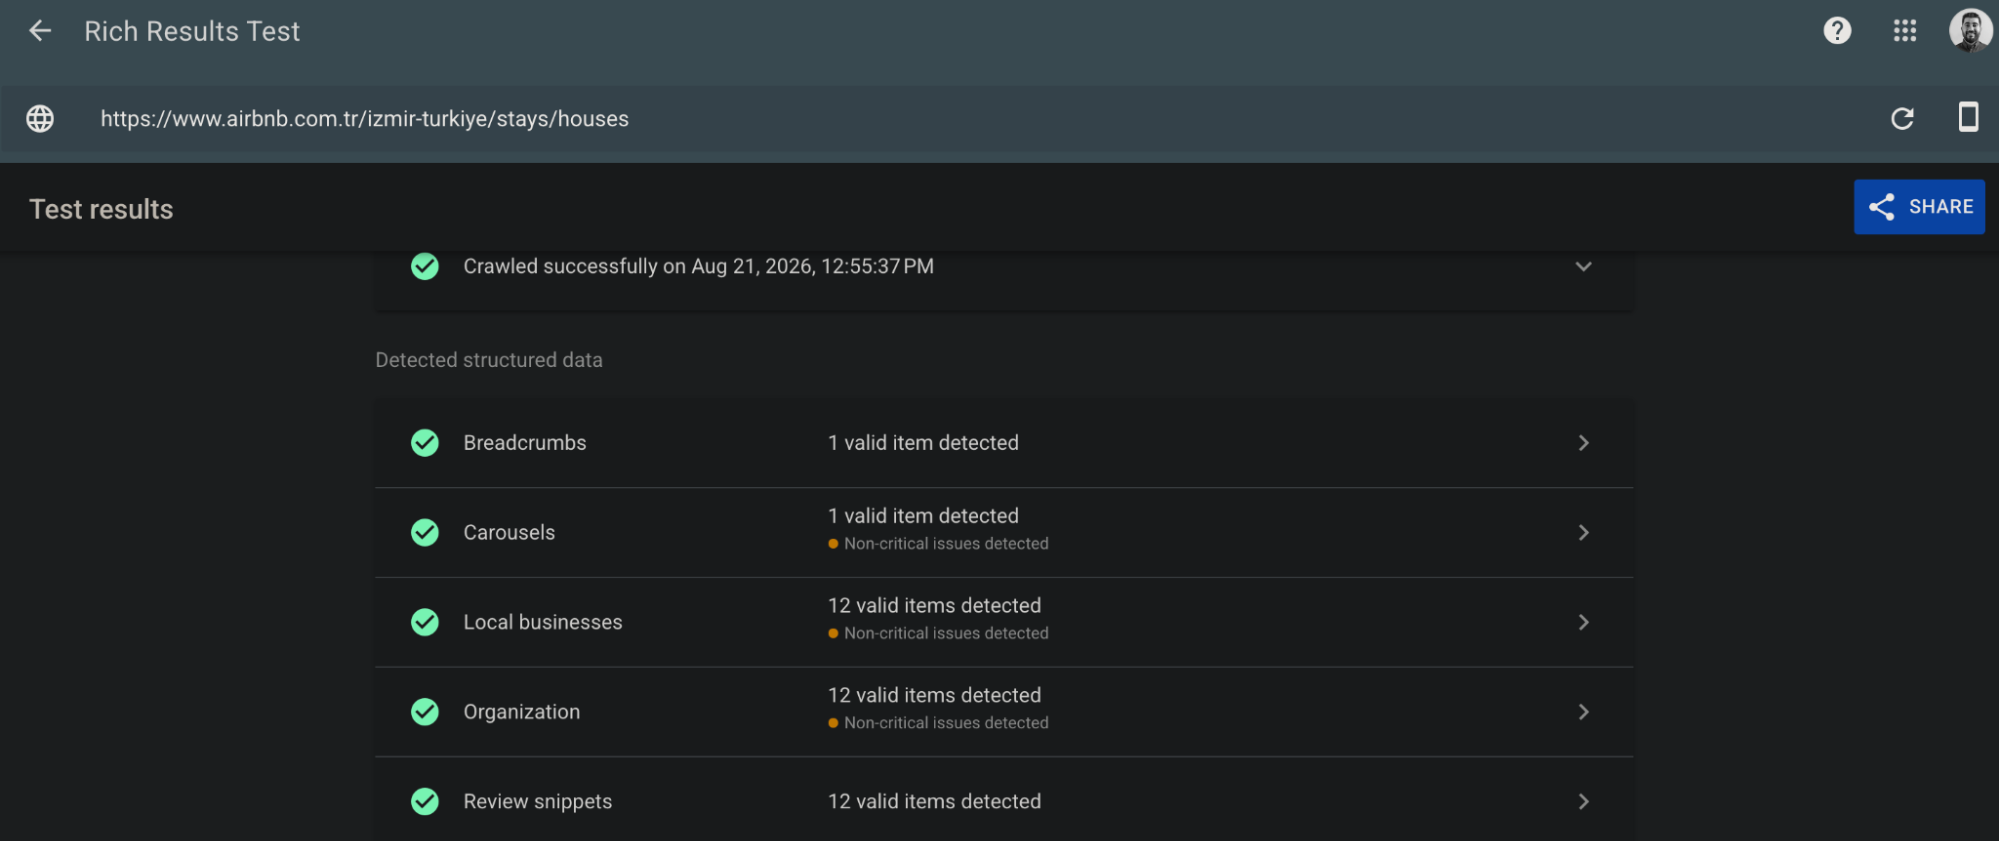
Yapısal veriler de HTML'de durmalıdır.
Zengin sonuçlar test aracı ile de sayfayı test ederek, Googlebot’un sayfadaki yapısal verileri görüp görmediğini test edebilirsiniz:
Geçmişse geçici çözüm olarak önerilen dynamic rendering, Google tarafından artık önerilmediği için yeni projelerinizde ya da proje geçişlerinde SSR veya SSG tercih etmenizi öneririm.
404 Durum Kodu
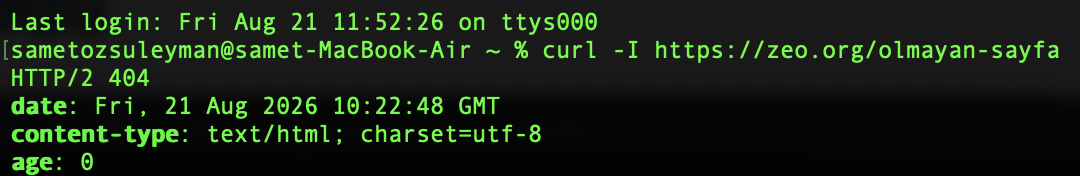
En sık gördüğüm hatalardan birisi de SEO’nun en temel konularından birisi olan 404. "Sayfa bulunamadı" ekranı gösterseniz bile sunucu 200 statu kodunu döndürdüğü için Google bu sayfayı soft 404 olarak işaretler ve tarama bütçesi için sorun oluşturur.
Aksiyon olarak sunucu tarafında: Next.js'te notFound() çkullanılmasıdır. Kendi sunucunuzu yönetiyorsanız, eşleşmeyen route'larda 404 durum koduyla yanıt dönmelidir.
Terminalde şu şekilde kontrol edebilirsiniz: curl -I https://zeo.org/olmayan-sayfa
Görseller İçin Hatırlatma
Site içi resimler mutlaka “img src” ile belirtilmelidir, Googlebot bunu araçlarında sorunsuz bir şekilde gösterse bile indexleyemediğini açıklamıştır.
Doğru kullanım;
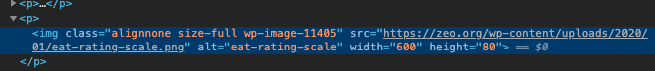
CSS background gibi uygulamaların React ile beraber kullanılması resimlerin indekslenmesinde sorun yaşanmasına sebep olacaktır.
Yanlış kullanım;
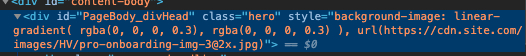
next/image kullanabilirsiniz:
import Image from 'next/image'
export default function Page() {
return (
<Image
src="/profile.png"
width={500}
height={500}
alt="Picture of the author"
/>
)
}
React.lazy ve Performans
Lazy loading, React projelerinde 2 farklı şey için kullanılıyor ve ikisi karıştırılmamalıdır.
1) Lazy loading: react-lazyload gibi paketlere gerek yok, tarayıcının kendisi için zaten loading="lazy" özniteliği yeterli. CWV analizlerinde bildiğimiz üzere LCP görsele zaten lazy uygulamıyoruz. next/image zaten bunları otomatik yönetiyor.
2) React.lazy: React.lazy, bir bileşenin kodunu ayrı bir parçaya bölüp sayfanın ilk yüklemesini hafifletir: Yorumlar sizin önemliyse ve butona basılınca yükleniyorsa Google bu şekilde yüklenen içeriği görmeyecektir. Bunu kullanırken dikkatli olmanızı öneririm.
const QABolumu = lazy(() => import("./QABolumu"));
Ağır bileşenleri ayırmayı iş planınıza alabilirsiniz. Örneğin haritalar ya da video oynatıcıları gibi büyük parçaları React.lazy ile bölebilirsiniz. Böylece bu kodlar sadece gerektiğinde yüklenir ve JavaScript boyutunu optimize edip INP metriğini optimize edebilirsiniz.
React'te SEO'nun yazımı tek cümleyle özetleyecek olursam: yapay zeka botlarının ve arama motorunun görmesi gereken her detay, sunucudan gelen HTML'de bulunmalı. Bunlar meta veriler, canonical, schema kodları, görseller, ana içerik ve linkler olarak düşünebilirsiniz. İlk kısımda anlattığım Render stratejisini doğru kurguladıysanız gerisi biraz teferruat :)


